Was wir gelernt haben:KI-Agenten für den IT-Service-Desk
Was braucht es, damit ein KI-Agent im IT-Service-Desk nachhaltig wirkt? Erfahrungen zu Prozessgestaltung, Datenmanagement und Nutzererlebnis.

· 8 Min. Lesezeit
Wenn wir mit Menschen über den klassischen IT-Service-Desk sprechen, stellen wir fest: Fast jeder verbindet damit frustrierende Erfahrungen.
Vermeidbare Frustration
Da ist der Mitarbeiter, der nicht weiterarbeiten kann: In vielen Unternehmen kann es im Durchschnitt eine Woche oder länger dauern, bis eine Anfrage gelöst ist, obwohl die eigentliche Arbeit nur einen Bruchteil dieser Zeit ausmacht. Viele berichten, dass man wissen muss, wem man privat eine Nachricht schreibt, oder die eigene Führungskraft einschalten muss, damit es schneller geht.
Auf der anderen Seite klingen auch die Geschichten der IT-Teams oft nach Frust. Die Tickets finden, für die man selbst zuständig ist, und die anderen weiterleiten. Immer dieselben Fragen, die längst im Wiki beantwortet sind – die nur niemand liest. Unklare Tickets ohne ausreichenden Kontext, die zur Klärung zurückgeschickt werden und die Lösungszeiten weiter verlängern.
IT-Leiter kennen diese Probleme. Sie möchten ihren Teams Zeit für wichtigere Aufgaben verschaffen, bei denen deren Fachwissen zählt, statt sie mit Aufgaben zu beschäftigen, für die sie überqualifiziert sind. Doch alte Prozesse am Laufen zu halten und die dadurch entstehenden Brände zu löschen, lässt vielen Organisationen kaum Zeit, diese Prozesse zu verbessern und die erheblichen und leicht erreichbaren Vorteile heutiger KI zu nutzen.
Die Früchte hängen tief – eigentlich
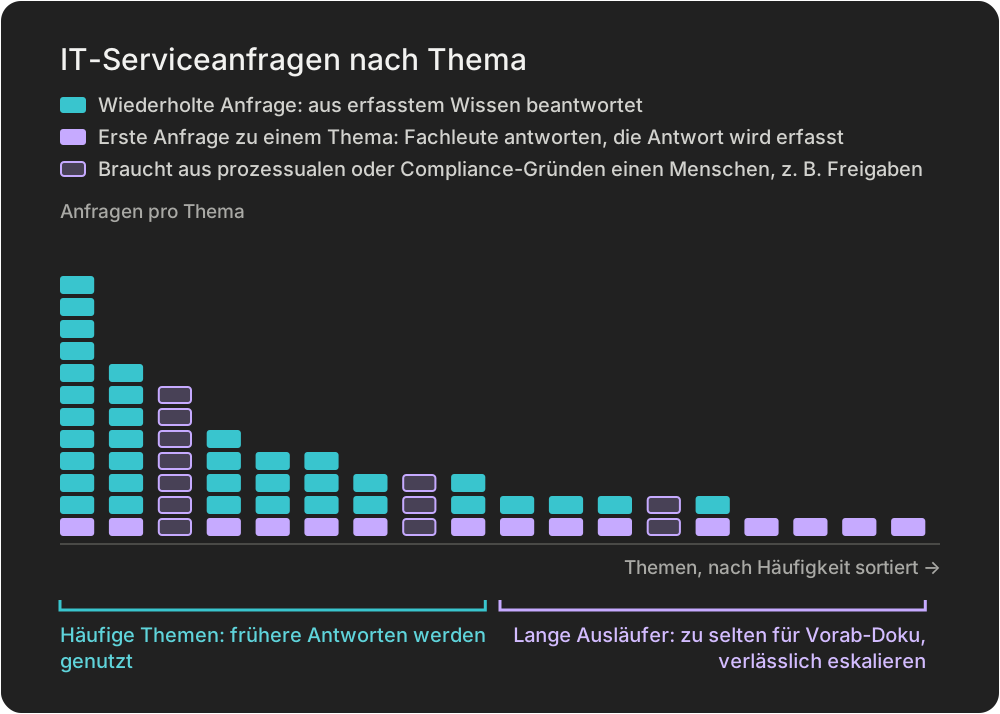
Wie häufig im Service folgen auch IT-Service-Desk-Tickets einer sogenannten generalisierten Zipf-Verteilung: Die häufigsten Themen machen einen großen Teil der Anfragen aus.
Themen, die sich häufig wiederholen, sind z. B. administrative Fragen, Zugänge, Berechtigungen und die Fehlerbehebung bei Systemen und Software oder die Bestellung von Hardware.
Das ist grundsätzlich eine gute Nachricht für KI-Agenten, denn viele Anfragen lassen sich mit existierenden Daten beantworten.
Unsere Einschätzung auf Basis unserer Analysen: Rund 50 % der Anfragen könnten sofort gelöst werden. Und auch wenn für die anderen aus Prozessgründen ein Mensch gebraucht wird oder die Daten noch nicht ganz reichen, lassen sich diese mithilfe von KI-Agenten sehr häufig auch schneller bearbeiten.
In der Praxis gehen diese Vorteile allerdings leicht verloren, wenn einige konzeptionelle Fehler nicht vermieden werden.
Das Problem mit den Daten
Ein zentrales Problem, mit dem viele Unternehmen bei der Einführung von KI kämpfen, sind ihre Daten. Genauer gesagt: die Vorstellung davon, in welchem Zustand sie sind und wie man sinnvoll mit ihnen umgeht.
In der Anfangszeit scheiterten viele KI-Piloten daran, dass man sie einfach in Betrieb nahm, ohne zu erkennen, dass die bereitgestellten Wiki-Artikel und FAQs als Wissensquellen unvollständig oder veraltet waren. Das entscheidende Wissen steckte stattdessen in den Köpfen der Menschen, die die Anfragen bearbeiteten. Solche Piloten konnten Nutzern nur gelegentlich helfen und führten sie mit Halluzinationen häufig in die Irre.
Ein KI-Agent, der nicht verlässlich hilft und zusätzliche Probleme verursacht, wird aber nicht dauerhaft genutzt. Wieder wird ein gescheiterter Pilot eingestellt.
Heute verstehen mehr Teams, dass ihre vorhandenen Dokumente, Wiki-Artikel und FAQs „nicht KI-bereit“ sind.
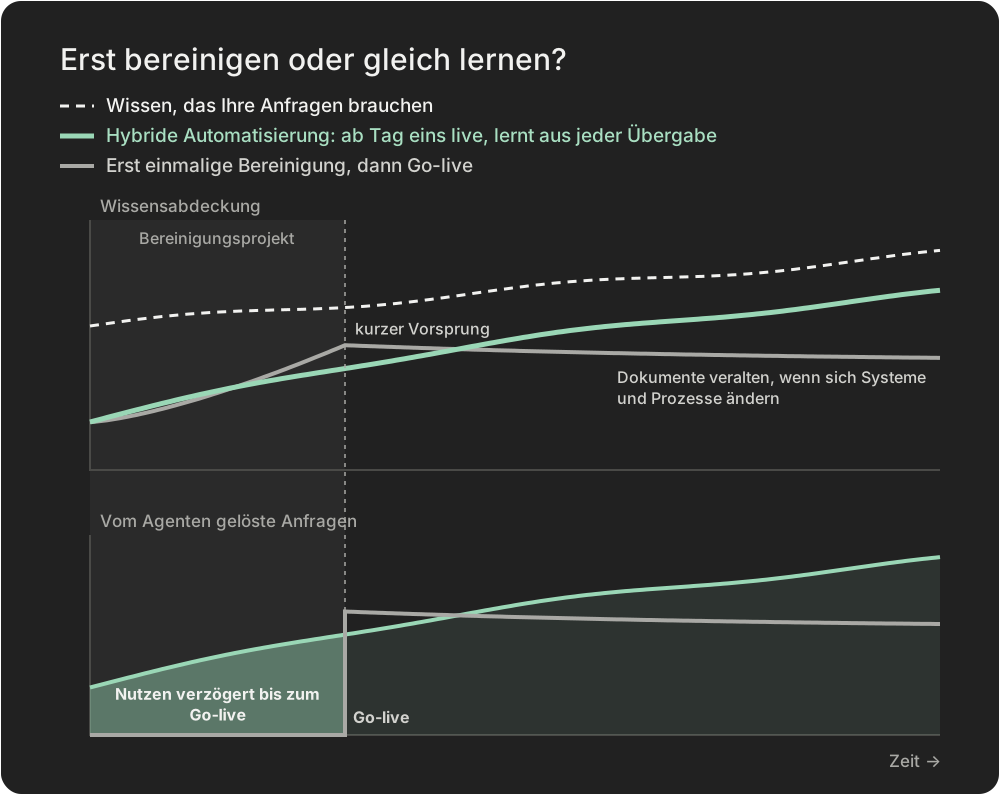
Doch nun wird die daraus gezogene Schlussfolgerung zum Engpass. „Wir müssen erst unsere Daten aufbereiten“ ist ein Missverständnis, das die leicht erreichbaren Vorteile plötzlich weit entfernt erscheinen lässt. Die dringend benötigte KI-Transformation stockt.
Es gibt allerdings keinen Zustand, in dem ein einmaliges Datenaufbereitungsprojekt abgeschlossen und damit „KI-Bereitschaft“ erreicht ist. Das benötigte Wissen verändert sich ständig.
Wissenspflege, die alleine auf manueller Arbeit basiert, scheitert immer wieder am damit verbundenen Aufwand. Auch wenn wir immer empfehlen, ein paar Stunden und Tage zu investieren, um offensichtliche und hochrelevante Lücken zu schließen, bietet die manuelle Wissenspflege alleine keine nachhaltige strategische Grundlage, um die Vorteile von KI-Agenten im IT-Service-Desk wirklich zu nutzen.
Wir brauchen also einen anderen Ansatz und das richtige Rezept.
Das Rezept, um Grenzen strategisch zu überwinden
1. Besser nutzen, was bereits vorhanden ist
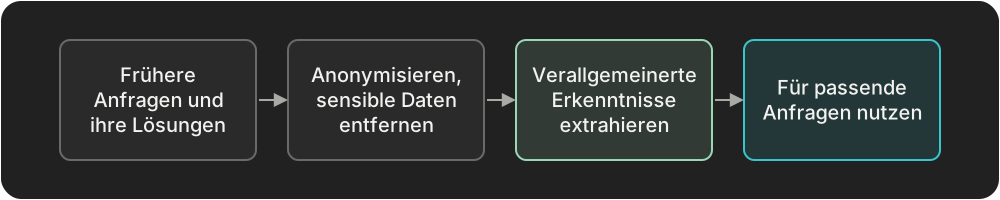
Nach unserer Erfahrung steckt das nützlichste digital verfügbare Wissen für IT-Service-Anfragen meist nicht in Quellen, die aktive Pflege erfordern, etwa Wikis oder FAQs. Es steckt in den digitalen Spuren früherer Anfragen.
Diese unterliegen allerdings Zugriffsberechtigungen und können sensible sowie personenbezogene Informationen enthalten. Ihre Nutzung erfordert deshalb eine sorgfältige Lösungsgestaltung.
Wir haben eine mehrstufige Wissensextraktionspipeline gebaut, die frühere Anfragen zunächst anonymisiert und sensible sowie personenbezogene Informationen herausfiltert. Eine zweite Stufe extrahiert daraus nur abstrakte, verallgemeinerte Erkenntnisse. So wird begrenzt, was den Agenten erreicht: verallgemeinertes Wissen, aus dem sensible Informationen herausgefiltert sind.
Es hat eine Weile gedauert, bis wir dort waren. Aber es lohnt sich. In der Praxis greifen solche KI-Agenten häufiger auf dieses extrahierte Wissen zurück als auf manuell gepflegte Quellen – sofern Letztere nicht in einem wirklich guten Zustand sind.
2. Allgemeines IT-Wissen der KI-Modelle nutzen
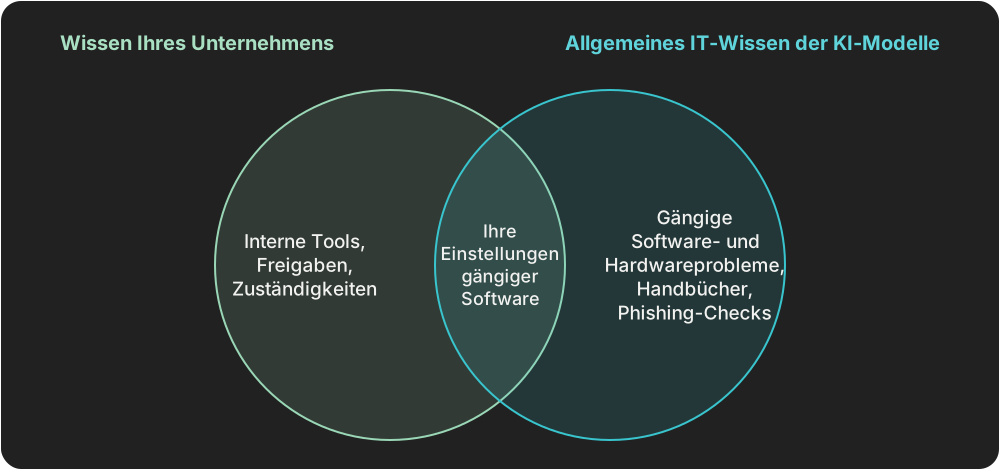
Wir haben außerdem festgestellt, dass das allgemeine IT-Wissen der Modelle bei vielen Anfragen hilft, selbst wenn die vorhandenen Daten keine Anleitung enthalten.
Viele Software- und Hardwareprobleme sind nicht organisationsspezifisch. Ein KI-Agent, der Handbücher nachschlagen kann, hilft dann oft deutlich schneller als ein Mensch.
Dasselbe allgemeine Wissen hilft auch bei der Sicherheit. KI-Agenten können eine Organisation widerstandsfähiger gegen Phishing machen, indem sie Mitarbeitern schnell Rückmeldung und Hinweise dazu geben, was sie tun und lassen sollten. Je unkomplizierter ich eine E-Mail prüfen lassen kann, desto eher vermeide ich es, in eine Falle zu tappen.
3. Quellen transparent und Antworten vertrauenswürdig machen
Ein zentrales Missverständnis, das mir in Gesprächen immer wieder begegnet: KI-Agenten werden eins zu eins mit Menschen verglichen, verbunden mit der Annahme, sie sollten alles automatisieren, was Menschen tun können. Doch Ihre Daten, allgemeine KI-Grenzen und prozessuale Anforderungen machen genau das zum Rezept fürs Scheitern.
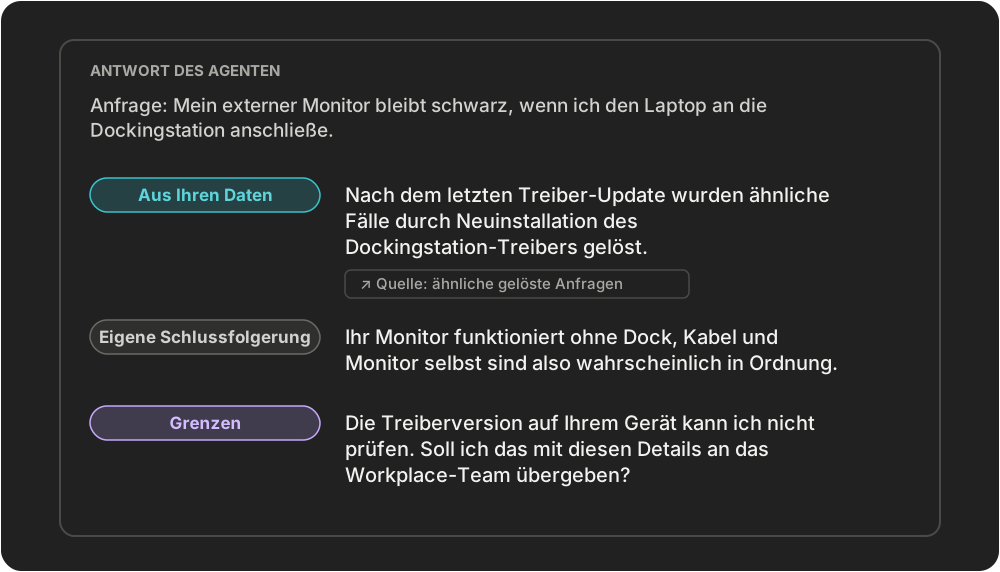
Damit KI-Agenten weniger Probleme verursachen, als sie lösen, und Nutzer ihnen vertrauen und sie dauerhaft einsetzen, müssen Grenzen sichtbar sein. Man sollte sie nicht verstecken.
Unsere Agenten trennen transparent zwischen dem, was sie in Daten gefunden haben, und dem, was sie selbst daraus ableiten. Sie liefern Quellen, die Menschen prüfen können. Und sie machen deutlich, wie weit die Belege reichen und was sie tun können.
4. Sackgassen vermeiden und mit Grenzen umgehen
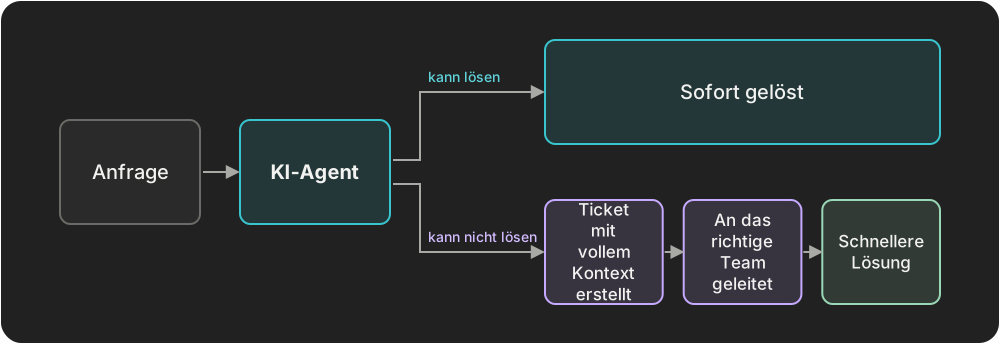
Wenn der KI-Agent bei einer Anfrage an eine Grenze stößt, sollte er nicht so tun, als könne er einfach darüber hinweggehen. Er sollte aber ebenso verhindern, dass der Nutzer in einer Sackgasse landet.
Wenn der KI-Agent mein Problem nicht löst und ich zurück ins klassische IT-Anfrageportal muss: Wie wahrscheinlich ist es dann, dass ich ihn beim nächsten Mal wieder versuche?
Wenn der Agent stattdessen ein Ticket für mich erstellt und dem richtigen IT-Team oder der richtigen Person zuweist, bin ich deutlich zufriedener. Ich habe sofort eine erste Rückmeldung erhalten, mir die Erstellung der Anfrage gespart, und das Ticket enthält bereits den nötigen Kontext. Weil es automatisch an die richtigen Menschen übergeben wurde, bekomme ich auch meine Lösung schneller. Natürlich komme ich wieder.
Dabei ist noch gar nicht berücksichtigt, wie viel angenehmer diese Veränderung auch für das IT-Team ist.
5. Ein System, das sich selbst verbessert
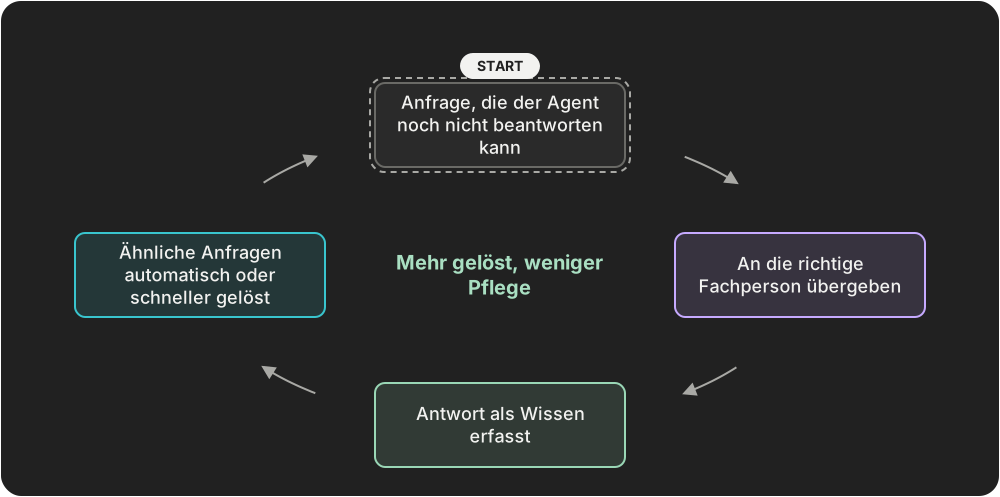
Das Beste am gesamten Aufbau? Er ist darauf ausgelegt, sich selbst zu verbessern und gemeinsam mit der Organisation weiterzuentwickeln.
Werden Anfragen, für die Wissen fehlt, an die richtigen Menschen übergeben, wird das relevante Wissen in ihren Köpfen erfasst, bewahrt und direkt in einer für KI geeigneten Form gespeichert.
Indem das System bisher fehlendes Wissen erfasst, kann es mehr Anfragen automatisch lösen und mehr Zeit freisetzen. Gleichzeitig entwickelt es sich mit der Organisation weiter. So bleibt das Wissen bei veränderten Anforderungen nützlich, und Produktivitätsgewinne bleiben mit weniger manueller Pflege erhalten.
Ganz nebenbei wird eines der wichtigsten Güter des KI-Zeitalters bewahrt – als Grundlage für weitere Produktivitätsgewinne.
Das bedeutet nicht, dass Mitarbeiter wichtiges Wissen nicht weiterhin aktiv dokumentieren können oder sollten. Eine kurze Notiz für die KI genügt oft schon. Aber der Ansatz vermeidet die Abhängigkeit von einem klassischen Wissensmanagement, das seit Jahrzehnten immer wieder an denselben Problemen scheitert.
Was „hybride Automatisierung“ bewirkt
Wir nennen diesen strategischen Ansatz hybride Automatisierung und steigern damit die Produktivität über den gesamten Prozess hinweg.
- Er schöpft aus, was KI sofort lösen kann.
- Er nutzt Teilautomatisierung, statt ihr Potenzial zu verwerfen.
- Er verbindet KI- und menschliche Arbeitsabläufe nahtlos.
- Er reduziert den Vorbereitungsaufwand und macht Vorteile schneller nutzbar.
- Er verbessert die Akzeptanz, damit sich diese Vorteile tatsächlich entfalten.
- Er verbessert sich selbst und entwickelt sich mit den Anforderungen weiter.
- Er schafft die strategische Grundlage, um künftig noch mehr von besseren KI-Modellen und weiteren Anwendungsfällen zu profitieren.
Wie Sie diese Vorteile nutzen, hängt von Ihrer Ausgangslage ab. Manche ersetzen ausgelagerte First-Level-Dispatch-Dienste, andere werden produktiver. Wieder andere sparen sich die Kosten für Nachbesetzungen oder den Ausbau ihrer IT-Teams.
Interessiert, was das für Ihren IT-Service-Desk bedeuten könnte?
oder per E-Mail an [email protected]